
工作原理
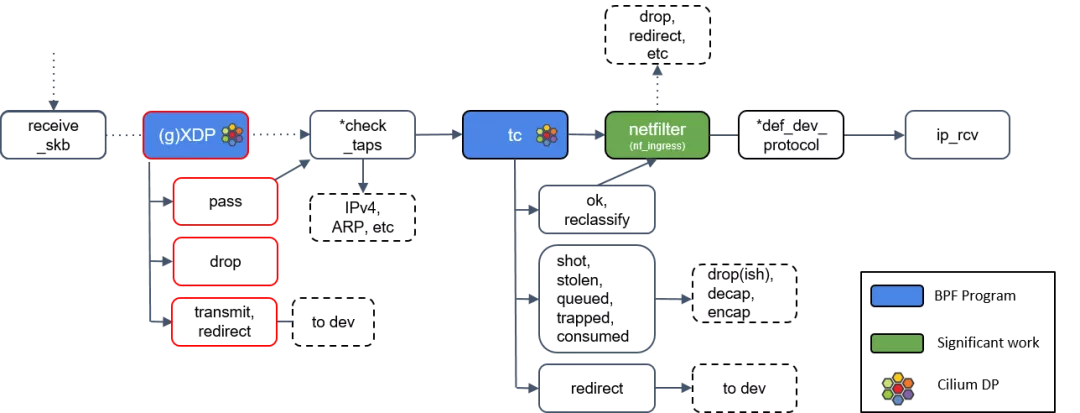
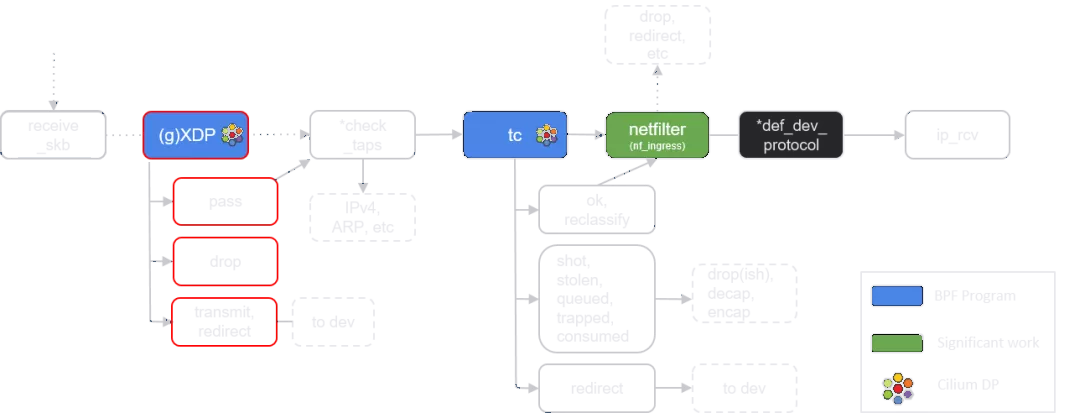
dae 透過 eBPF 將程式載入到 Linux 核心的 tc(流量控制)掛載點。該程式會在流量進入 TCP/IP 網路堆疊前分流。
下圖展示 tc 在 Linux 網路協定堆疊中的位置。圖中為接收路徑,傳送路徑方向相反;netfilter 表示 iptables/nftables 所在的位置。
流量分流原理
分流條件
dae 支援按網域、來源 IP、目的地 IP、來源連接埠、目的地連接埠、TCP/UDP、IPv4/IPv6、行程名稱、MAC 位址等因素分流。
其中,來源 IP、目的地 IP、來源連接埠、目的地連接埠、TCP/UDP、IPv4/IPv6 和 MAC 位址可透過解析 MACv2 訊框獲得。
dae 在 cgroupv2 掛載點監控本地行程的 socket、connect 和 sendmsg 系統呼叫,再讀取並解析行程控制區塊中的命令列,從而獲得行程名稱。此方法顯著快於 Clash 等掃描整個 procfs 獲取行程資訊的使用者空間程式,後者甚至可能耗時數十毫秒。
網域透過攔截 DNS 請求,並將請求的網域與相應 IP 位址關聯獲得。但此方法有一些潛在問題:
- 可能導致誤判。例如,在短時間內同時存取共用同一 IP 位址的國內和國外網站,或瀏覽器使用 DNS 快取時。
- 使用者的 DNS 請求必須經過 dae。可透過將 dae 設為 DNS 伺服器,或在 dae 作為閘道時使用公共 DNS 實現。
儘管有這些限制,與其他方法相比,此方法仍是最優方案。Fake IP 方法無法按 IP 分流,並且存在嚴重的快取汙染問題。網域嗅探只能檢查 TLS、HTTP 和 QUIC 等流量。
SNI 嗅探可用於分流,但 eBPF 對程式複雜度的限制使網域嗅探只能留在使用者空間。eBPF 程式本身用 bpf_loop 做規則匹配和行程名稱解析,因此 dae 要求核心 5.17 或更高版本。
因此,如果 DNS 請求無法經過 dae,基於網域的分流將無法成功。
TCP 嗅探有時間限制。sniffing_timeout(預設 30 毫秒)和 dial_mode: ip 只約束 TCP 嗅探和自動插入的 sniff-punt 規則。dae 先等待最多 sniffing_timeout,讀取用戶端 TCP 載荷的前 16 位元組。若沒有資料到達,或資料不像 TLS 握手或 HTTP 請求,dae 按 IP 路由。
資料像 TLS 握手或 HTTP 請求時,dae 啟動嗅探器,以新的 sniffing_timeout 為期限繼續讀取 TCP 分段,直到 TLS ClientHello 完整或期限到期。因此 SNI 不必位於第一個分段。HTTP 只在已讀取的位元組中檢查一次。若未找到網域,則退回按 IP 分流。dae 從不嗅探目的地連接埠為 20、21、22、25、53、119、123、161、3306、5432、6379、9200、27017 和 11211 的 TCP 連線。
UDP 嗅探忽略這兩個選項。僅當 UDP 封包的來源連接埠或目的地連接埠為 443 或 8443,且封包看起來是 QUIC Initial 時,dae 才會嗅探。dae 將這類封包儲存在按連線(DCID)區分的嗅探器中,直到解析出 SNI;工作階段 TTL 上限為 5 秒。在 dial_mode: ip 下,dae 不會用嗅探到的 QUIC 網域選擇連線目標。
對於 TCP,同一流簽章(目的位址和連接埠、行程名稱、MAC 位址和 DSCP)連續 3 次嗅探失敗後,dae 會在 10 分鐘內停止嗅探該簽章;任何一次嗅探成功都會清除該條目。這個負向快取讓起始資料中始終不含網域的流不會在每次連線時重複嘗試網域匹配。UDP 採用獨立的按 DCID 策略:連續 4 次沒有 SNI 就暫停嗅探 1 秒,連續 2 次解密失敗就放棄該 DCID。隨後 dae 會繞過失敗的 DCID:沒有 SNI 時 15 秒,解密失敗時 30 秒,嗅探器 panic 時 1 分鐘;重複失敗時翻倍,上限 5 分鐘。
當某臺裝置設定了網域白名單,卻使用自己的加密 DNS 時,dae 會自動插入核心空間的嗅探退回規則。即使該裝置的 DNS 請求不經過 dae,白名單也能繼續生效,但僅限 dae 能嗅探的連線。這類連線包括目的地連接埠不在上述排除清單、首個分段為 TLS 或 HTTP 的 TCP 連線,以及連接埠 443 或 8443 上攜帶 QUIC Initial 的 UDP 連線。當 dae 跳過一條被送往使用者空間的連線,或未找到網域時,會不帶網域重新路由該連線。因此該連線會命中該裝置僅按選擇器匹配的退回規則,且仍經使用者空間轉送。參見路由規則中的 auto_sniff_punt。
dae 在使用者空間使用網域嗅探,以緩解 DNS 汙染並提高 CDN 連線速度。在預設的
dial_mode: domain下,只有 dae 的 DNS 快取已有該網域的 A 或 AAAA 記錄,或此前的後臺探測已確認該網域可解析時,dae 才會將嗅探到的網域而非 IP 位址傳送給代理伺服器。首次連線未知網域時,dae 使用原始 IP 連線,並透過bootstrap_resolver啟動後臺探測。沒有應答的網域會作為負向結果快取 10 秒。domain+和domain++跳過此檢查,總是傳送嗅探到的網域。代理伺服器會重新解析網域,並使用最優 IP 連線。已使用其他分流方案的高階使用者,可能不希望讓 DNS 請求經過 dae,但仍需按網域分流部分流量。此時可設定
dial_mode: domain++,強制使用嗅探到的網域分流。例如,按目標網域將流量分配給 Netflix 節點和下載節點,並讓部分流量經核心直連。
dae 透過 tc 掛載點的程式重新導向流量實現分流。重新導向基於分流結果:將流量重新導向至 dae 的 tproxy 連接埠,或讓其繞過 dae 直接通過。
代理機制
dae 的代理機制與其他程式相似,繫結不同介面時的處理方式如下:
| 繫結介面 | 處理方式 |
|---|---|
| LAN | 在繫結介面的 tc ingress 上,eBPF 只改寫乙太網路頭(目的 MAC 設為 dae0peer),把該流記錄到 redirect_track,並將 skb->cb[0] 設為 TPROXY_MARK(0x8000000)。然後 eBPF 用 bpf_redirect 把未改動的 IP 封包重新導向到 dae0。若為 netkit 對,且核心已包含 CVE-2025-37959 的修復(主線 6.14.7 或更高版本),則跳過 MAC 改寫,改用 bpf_redirect_peer。 |
| WAN | 在繫結介面的 tc egress 上,eBPF 執行同樣的改寫和記錄,再呼叫 bpf_redirect 重新導向到 dae0。應答封包經 dae0 ingress 返回,由該處恢復原始 MAC,並以 BPF_F_INGRESS 重新導向到該介面的入口佇列。 |
兩條路徑都保持目的位址、連接埠和校驗和不變。dae 的 tproxy 監聽器在 daens 網路名稱空間內監聽 tproxy_port(預設 12345)。在 dae0peer ingress 上,eBPF 丟棄 skb->cb[0] 不帶 TPROXY_MARK 的封包,並把 skb->mark 設為 0x8000000。因為有這個 mark,策略規則 fwmark 0x8000000/0x8000000 table 2023 會把封包交給 local default dev lo。eBPF 再呼叫 bpf_sk_assign,把 UDP 封包和 TCP SYN 關聯到該監聽器。已建立連線的 TCP 分段經這條本地路由到達 socket,無需再關聯。
從基準測試看,dae 的代理效能略高於其他代理程式,但差異不顯著。
自 PR:implement stack bypass 起,劫持資料路徑已改為繞過協定堆疊,以獲得更好的效能並減少協定堆疊的影響(例如 netfilter、systemd-sysctl)。請參閱 PR 描述以進一步瞭解。
直連機制
傳統分流方式先讓流量進入代理程式的分流模組,再決定使用代理還是直連。流量經網路堆疊解析、處理和複製後送入代理程式,隨後又經網路堆疊複製、處理和封裝後發出。這會消耗大量資源。
在 BitTorrent 下載等場景中,即使設為直連,仍會消耗大量連線、連接埠、記憶體和 CPU 資源。在遊戲場景中,代理程式處理不當甚至可能影響 NAT 型別,導致連線錯誤。
dae 在更早的核心階段進行流量分流,透過第 3 層路由轉送直連流量。該方法透過減少核心與使用者空間之間的切換來降低開銷。此時 Linux 的作用是純交換器或路由器。
路由到 direct 的 LAN 流量總是走這條核心路徑,並把 skb->mark 設為規則的 mark。對於 dae 主機自身的流量,只有 mark 為 0 的 direct 才會繞過代理程式。dae 使用者空間的 direct dialer 透過 SO_MARK 設定 mark。它負責處理 mark 非零的 direct(mark: N)、送往非 must 出站的 DNS 查詢,以及嗅探後由使用者空間重新路由到 direct 的連線。
具有特定網路拓撲的高階使用者應先設定核心參數,再停用 dae。將裝有 dae 的裝置設為閘道後,其他裝置仍應能正常存取網路。例如,存取 223.5.5.5 應返回
UrlPathError回應。在裝有 dae 的裝置上執行 tcpdump,應能看到用戶端裝置發出的請求封包。
因此,dae 不會對直連流量執行 SNAT。在“旁路由”設定中,這會導致非對稱路由。在此場景中,用戶端裝置發出的流量經 dae 到達閘道,而接收流量則從閘道直接到達用戶端裝置,繞過 dae。
此處的旁路由須同時滿足三個條件:作為閘道執行、對 TCP/UDP 執行 SNAT、LAN 和 WAN 介面位於同一網段。
例如,筆記型電腦為 192.168.0.3,旁路由為 192.168.0.2,路由器為 192.168.0.1,則邏輯三層拓撲為:筆記型電腦 -> 旁路由 -> 路由器。在路由器側,只能看到來源 IP 為 192.168.0.2 的 TCP/UDP 流量,不會看到來源 IP 為 192.168.0.3 的 TCP/UDP 流量。
上游作者表示,據其所知,這一定義由他們首次提出。
非對稱路由帶來一個優勢和一個潛在問題:
- 效能優勢:返回流量不經過 dae,路徑更短,直連效能與沒有旁路由時一樣快。
- 潛在問題:可能破壞有狀態防火牆的狀態維護並造成封包遺失,例如 Sophos Firewall。不過,家庭網路通常不會出現此問題。
基準測試表明,dae 的直連效能優於其他代理方案。
來源:dae 上游文件 · AGPL-3.0 授權條款。